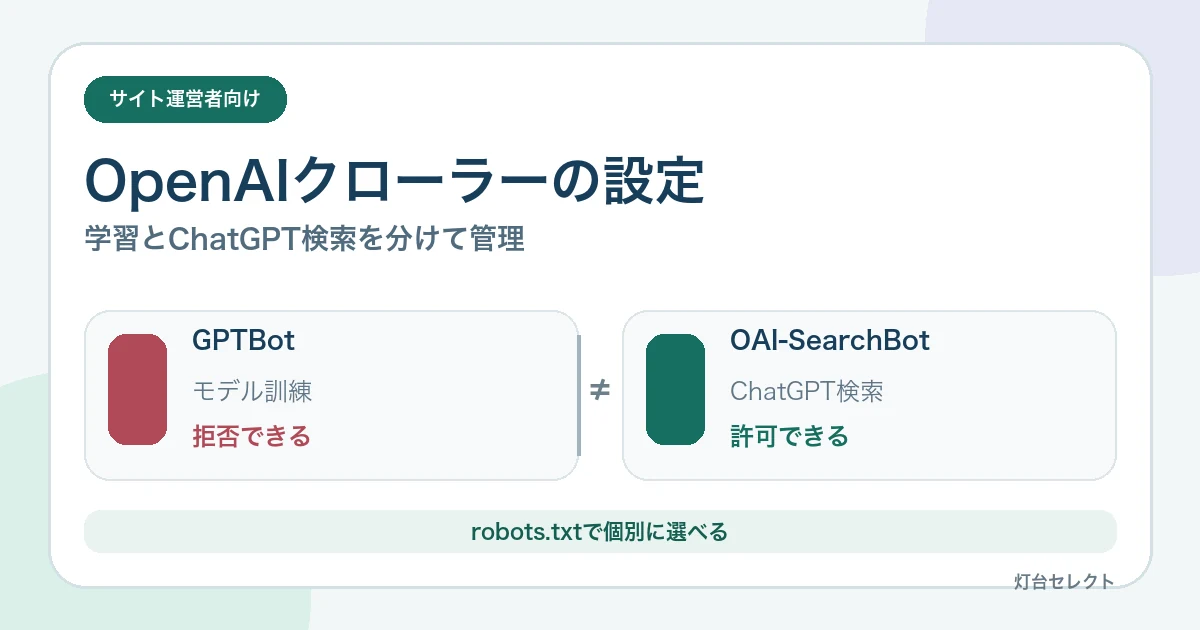
Webサイトの内容をOpenAIのモデル学習に使わせたくない場合は、robots.txtでGPTBotを拒否します。一方、ChatGPTの検索結果には掲載されたい場合、OAI-SearchBotは許可します。この2つは別々に設定できます。
「学習は拒否、ChatGPT検索は許可」にしたいサイトは、GPTBotだけを拒否します。OAI-SearchBotまで拒否すると、ChatGPT検索の回答にサイトが表示されなくなります。設定変更が検索側へ反映されるまで、OpenAI公式では約24時間かかる場合があると案内しています。
確認日:2026年11月5日。この記事はOpenAIのクローラー公式資料を基に、サイト運営者向けにGPTBot、OAI-SearchBot、ChatGPT-Userの役割と設定例を整理したものです。灯台セレクトのrobots.txtを変更して試した記事ではありません。
GPTBotとOAI-SearchBotの違い
| ユーザーエージェント | 主な目的 | 拒否した場合 |
|---|---|---|
| GPTBot | 生成AIの基盤モデルの訓練に使われる可能性がある内容をクロール | サイトの内容をモデル訓練に使わない意思を示す |
| OAI-SearchBot | ChatGPTの検索機能でWebサイトを表示するためにクロール | ChatGPT検索の回答には表示されない。ただしナビゲーション用リンクとして出る場合はある |
| ChatGPT-User | 利用者の依頼を受けてChatGPTやカスタムGPTがページへアクセス | 自動巡回用ではなく、ユーザー操作が起点のためrobots.txtが適用されない場合がある |
混同しやすいのは、GPTBotを拒否するとChatGPT検索にも出なくなると思ってしまう点です。OpenAIは、OAI-SearchBotを許可しながらGPTBotを拒否できると明記しています。検索からの流入を残しつつ、モデル訓練への利用を拒否したい場合に使える分け方です。
学習を拒否し、ChatGPT検索は許可する設定
robots.txtへ次のように記載します。
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /この設定では、OAI-SearchBotによる検索用クロールは許可し、GPTBotによる学習用途のクロールはサイト全体で拒否します。すでに別のルールがある場合は、既存のUser-agentやDisallowとの競合を確認してから追加してください。
学習もChatGPT検索も拒否する設定
両方を拒否する場合は、それぞれにDisallow: /を指定します。
User-agent: OAI-SearchBot
Disallow: /

User-agent: GPTBot
Disallow: /
OAI-SearchBotを拒否すると、ChatGPT検索の回答にサイトが表示されなくなります。OpenAIは、直接そのサイトを探すナビゲーション用リンクとしては表示される場合があると説明しています。検索流入を重視するサイトでは、学習拒否だけを目的にOAI-SearchBotまで止めないよう注意が必要です。
特定のフォルダだけ拒否する設定
会員向け資料やテスト用ディレクトリなど、特定のパスだけを対象にすることもできます。次は/private/を両方のクローラーから拒否する例です。
User-agent: OAI-SearchBot
Disallow: /private/

User-agent: GPTBot
Disallow: /private/robots.txtはアクセス制御や認証の代わりではありません。外部へ公開してはいけない情報は、ログイン制限など別の方法で保護する必要があります。
ChatGPT-Userは自動巡回とは役割が違う
ChatGPT-Userは、利用者がChatGPTやカスタムGPTへ質問したときなどにページへアクセスするユーザーエージェントです。OpenAIは、自動的なWebクロールには使わず、利用者の操作を起点とするためrobots.txtのルールが適用されない場合があると説明しています。
また、ChatGPT-Userは検索結果への掲載可否を決めるものではありません。ChatGPT検索からの除外や自動クロールの管理には、OAI-SearchBotの設定を使います。
設定前に決める3つのこと
- モデル訓練への利用を許可するか:GPTBotで管理する
- ChatGPT検索への掲載を許可するか:OAI-SearchBotで管理する
- サイト全体か一部パスか:
Disallowの範囲を決める
「AIをすべて拒否する」という一括判断ではなく、訓練と検索流入を分けて考えるのがポイントです。特にメディアや企業サイトでは、検索流入を維持しながら学習用途だけを拒否する選択肢があります。
設定後の確認方法
- ブラウザで
https://自分のドメイン/robots.txtを開き、公開内容を確認する - GPTBotとOAI-SearchBotの指定が意図どおりか確認する
- 既存の検索エンジン向けルールを壊していないか確認する
- サーバーログを確認できる場合は、ユーザーエージェントとOpenAI公開のIPアドレス情報を照合する
OpenAI公式では、OAI-SearchBotの設定変更が検索側へ反映されるまで約24時間かかる場合があるとしています。更新直後の表示だけで失敗と判断せず、時間を置いて確認します。
ChatGPTの入力データ設定とは別
今回のrobots.txt設定は、Webサイト運営者がクローラーへ示すルールです。ChatGPTへ入力した会話をモデル改善に使わせない設定とは対象が違います。個人の会話データについては、ChatGPTの学習利用をオフにする方法で、履歴・Temporary Chat・Memoryとの違いを整理しています。
また、ChatGPT検索、Deep research、Workの使い分けはChatGPTの調査機能比較で確認できます。検索結果へサイトを出したいか判断する前に、ChatGPT検索がどのような用途で使われるかを把握しておくと設定を決めやすくなります。
よくある質問
GPTBotを拒否するとChatGPT検索にも出ませんか?
GPTBotとOAI-SearchBotは独立しています。GPTBotだけを拒否し、OAI-SearchBotを許可すれば、モデル訓練への利用を拒否する意思を示しながらChatGPT検索への掲載を許可できます。
OAI-SearchBotを拒否すれば完全にリンクが消えますか?
OpenAIは、ChatGPT検索の回答には表示されない一方、ナビゲーション用リンクとして表示される場合があると説明しています。あらゆる状況でURLが完全に出なくなるという案内ではありません。
robots.txtで非公開情報を守れますか?
いいえ。robots.txtはクローラーへの指示であり、認証やアクセス制限ではありません。非公開情報は公開ディレクトリへ置かず、ログインや権限管理で保護します。
公式情報
まとめ
OpenAIのクローラーは、学習用のGPTBot、検索用のOAI-SearchBot、利用者の操作を起点とするChatGPT-Userで役割が異なります。学習だけを拒否したい場合はGPTBotを止め、ChatGPT検索へ掲載したい場合はOAI-SearchBotを許可します。目的を決めてから対象パスを設定し、既存のrobots.txtを壊していないことまで確認してください。